Statistica: Modulo B, causalità, correlazione e regressione lineare
Documento di Università su Statistica: Modulo B. Il Pdf, un appunto di Matematica di livello universitario, esplora concetti chiave come causalità, correlazione e regressione lineare, includendo la verifica delle ipotesi statistiche con esempi e formule.
See more22 Pages

Unlock the full PDF for free
Sign up to get full access to the document and start transforming it with AI.
Preview
Causalità e Correlazione
STATISTICA: MODULO B mercoledì 20 marzo 2024 16:42 CAUSALITA' Una relazione di causa-effetto (o di CAUSALITA') stabilisce una implicazione logica tra una quantità (fenomeno), che rappresenta la «causa», e un'altra che si verifica come conseguenza, ovvero come «effetto». La CORRELAZIONE indica il grado di relazione, ovvero interdipendenza, tra due variabili.
CAUSALITÀ -> CORRELAZIONE
- (causalità indiretta)
Tipi di Correlazione
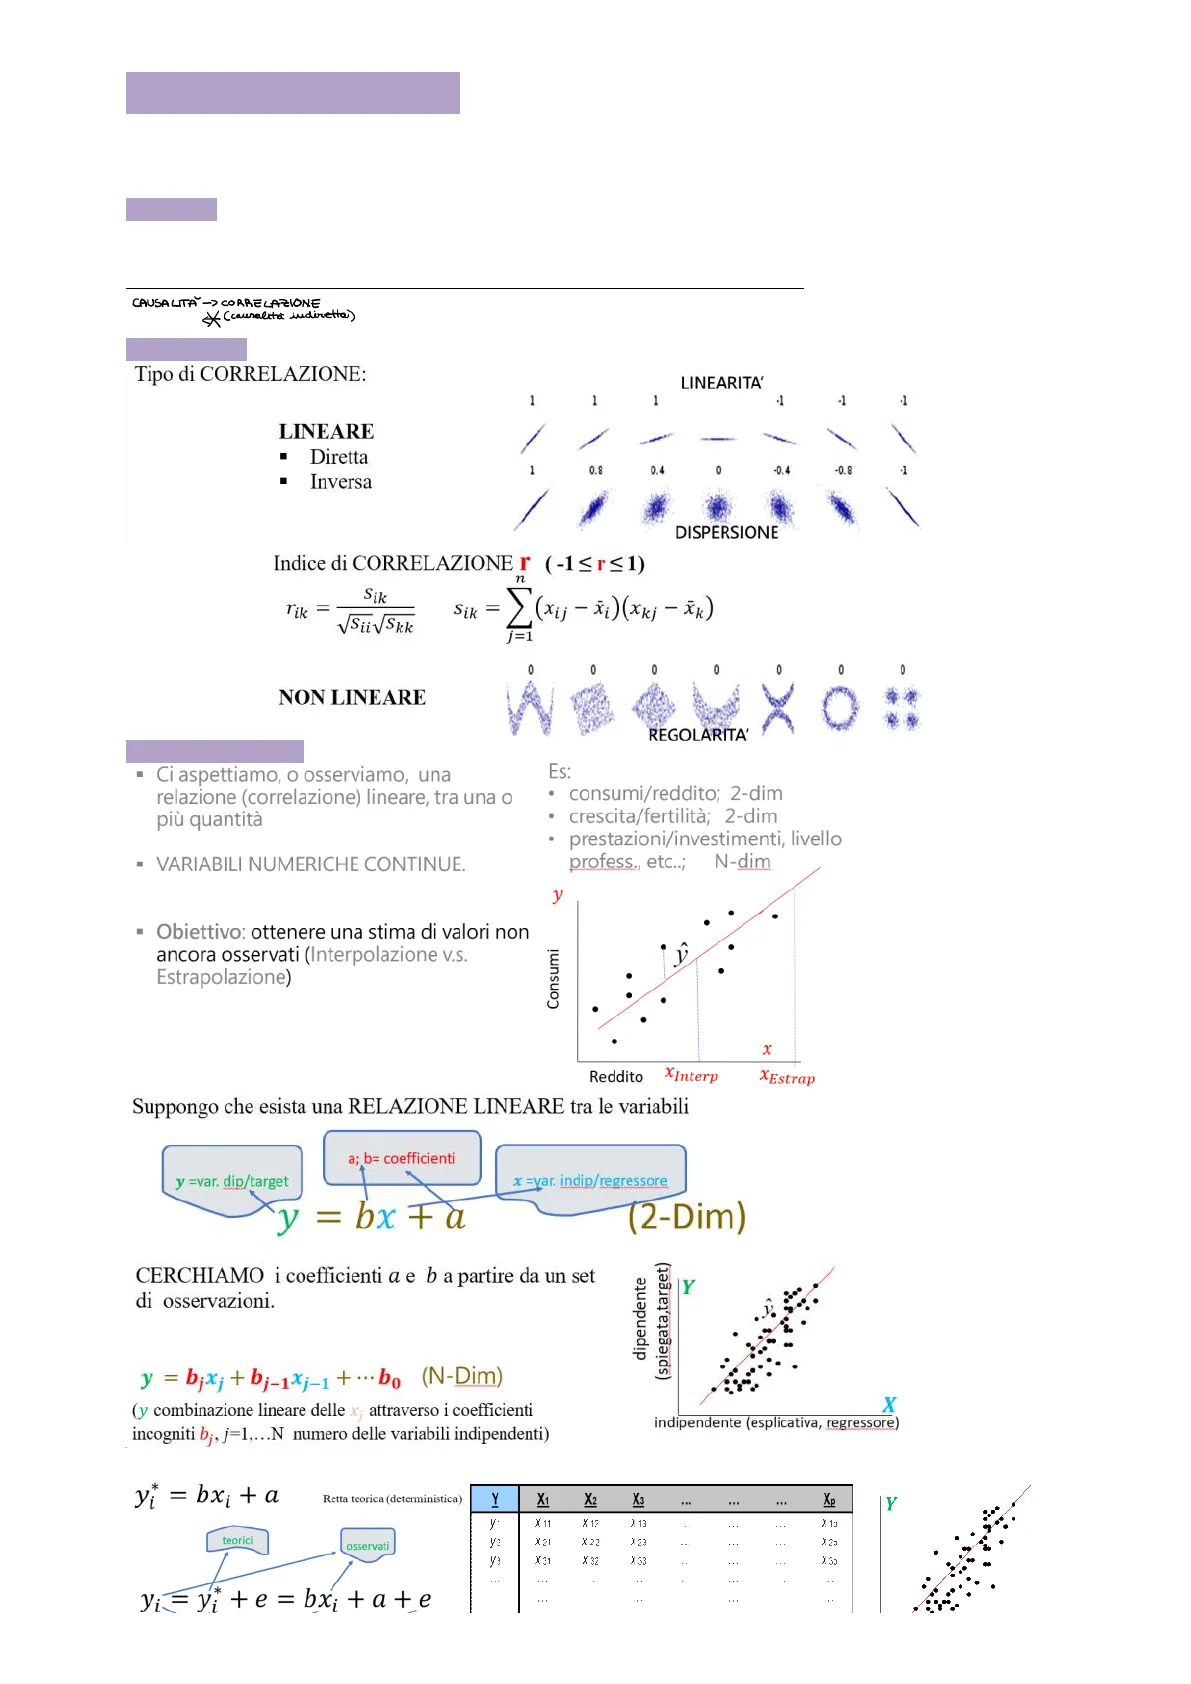
CORRELAZIONE Tipo di CORRELAZIONE: LINEARITA' 1 1 1 .1 -1 -1 LINEARE · Diretta . Inversa 1 0.8 0.4 0 -0.4 -0.8 -1 DISPERSIONE Indice di CORRELAZIONE r (-1 ≤r≤1) n Tik = Sik =>(xj-xi)(Xkj-xx) Sik j=1 0 0 0 0 0 0 0 REGOLARITA'
Regressione Lineare
REGRESSIONE LINEARE · Ci aspettiamo, o osserviamo, una relazione (correlazione) lineare, tra una o più quantità · VARIABILI NUMERICHE CONTINUE. · Obiettivo: ottenere una stima di valori non ancora osservati (Interpolazione v.s. Estrapolazione) Es: · consumi/reddito; 2-dim · crescita/fertilità; 2-dim · prestazioni/investimenti, livello profess,, etc ..; N-dim y Consumi x Reddito XInterp XEstrap
Relazione Lineare e Coefficienti
Suppongo che esista una RELAZIONE LINEARE tra le variabili a; b= coefficienti y =var. dip/target x =var. indip/regressore y = bx Ta (2-Dim) CERCHIAMO i coefficienti a e b a partire da un set di osservazioni. y = bjxj + bj-1xj-1 + ... bo (N-Dim) (y combinazione lineare delle x, attraverso i coefficienti incogniti bj, j=1, ... N numero delle variabili indipendenti) dipendente Y X indipendente (esplicativa, regressore) yi = bxi + a Retta teorica (deterministica) X1 X2 X3 ... ... ... Xp Y y X 11 X 13 X 13 X 1: X21 X 22 X ZE X2: y3 X3 X 32 X 33 X 3: yi= yi +e = bxitate Y teorici osservati (spiegata,target) MATEMATICA Pagina 1 NON LINEARELeUTILI osservati Y Z A. 25 AZ: y3 × 32 X 33 X 3: .. . ... Xr Xn X -: ... (nx1) (nxp) yi = yi + e = bxi +a+e
Minimi Quadrati
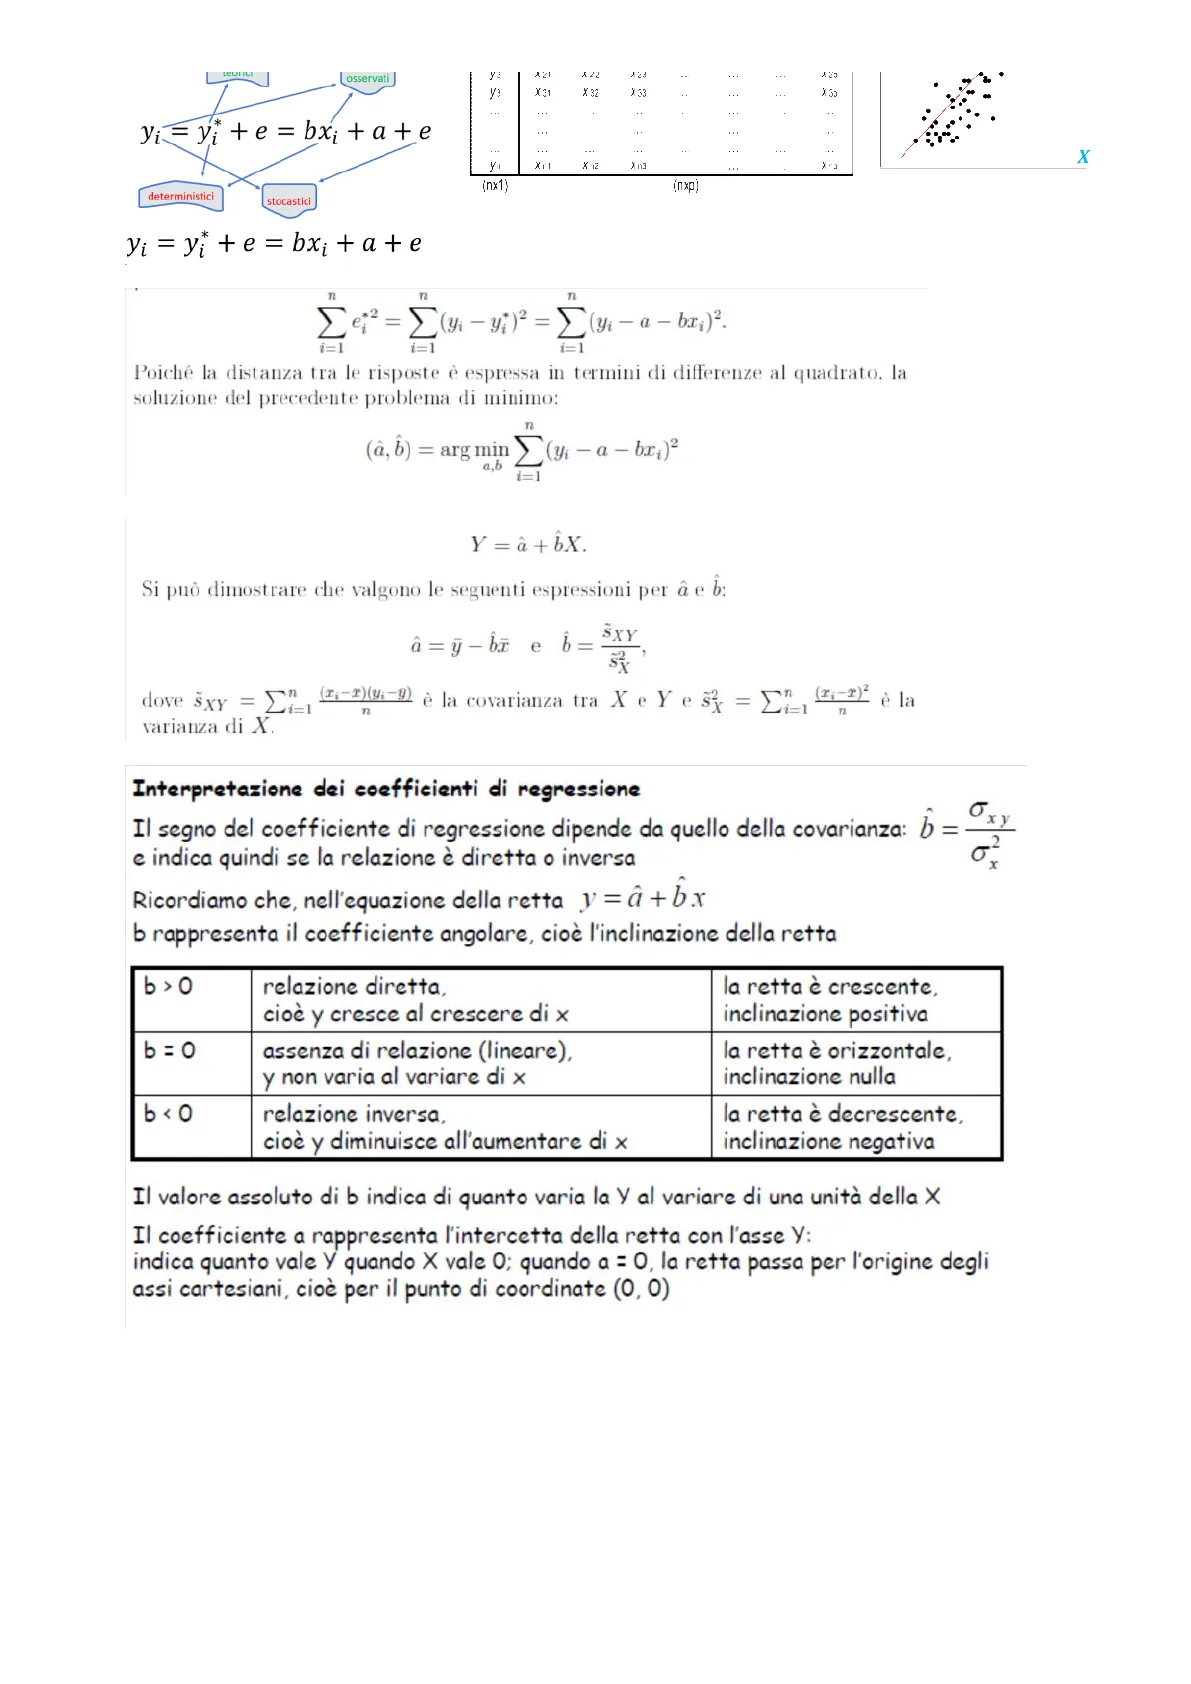
La retta teorica (regressione) è individuata da a e b che rendono minima la distanza: Le2 i=1 i=1 (yi-yi)2 =) i=1 n (yi-a -bx;)2. Poiché la distanza tra le risposte è espressa in termini di differenze al quadrato, la soluzione del precedente problema di minimo: (â, b) = arg min a,b n i=1 (yi - a - bx;)2 La retta dei MINIMI QUADRATI, che minimizza la somma dei quadrati dei residui è dunque: Y=â+ÎX. Si può dimostrare che valgono le seguenti espressioni per â e b: È e b= Egy, dove SxY = Li=1 (z ;- )(y-9) è la covarianza tra X e Y e s'y = 2i=1 varianza di X.
Interpretazione dei Coefficienti di Regressione
La retta dei minimi quadrati: Interpretazione dei coefficienti di regressione Il segno del coefficiente di regressione dipende da quello della covarianza: b 0 N e indica quindi se la relazione è diretta o inversa 0 Ricordiamo che, nell'equazione della retta y = â + bx b rappresenta il coefficiente angolare, cioè l'inclinazione della retta b> 0 relazione diretta, cioè y cresce al crescere di x la retta è crescente, inclinazione positiva b= 0 assenza di relazione (lineare), y non varia al variare di x la retta è orizzontale, inclinazione nulla b ‹ 0 relazione inversa, cioè y diminuisce all'aumentare di x la retta è decrescente, inclinazione negativa Il valore assoluto di b indica di quanto varia la Y al variare di una unità della X Il coefficiente a rappresenta l'intercetta della retta con l'asse y: indica quanto vale Y quando X vale 0; quando a = 0, la retta passa per l'origine degli assi cartesiani, cioè per il punto di coordinate (0, 0) MATEMATICA Pagina 2 X deterministici stocastici yi - yi +e = bx; +a+e
Proprietà dei Residui di Regressione
Il modello stimato può essere valutato, coerentemente con il criterio che è stato utilizzato per costruirlo, sulla base della somma dei quadrati degli scarti tra valori osservati e valori stimati, cioè la somma dei quadrati dei residui di regressione: n i=1 = i=1 I residui della regressione lineare ai minimi quadrati godono di 4 importanti proprietà: tutte queste proprietà derivano dalle equazioni normali, ovvero dalle condizioni che sono state imposte per determinare i parametri della retta di regressione, in modo da minimizzare la somma dei quadrati dei residui stessi Le 4 Proprietà dei Residui di Regressione n =>(y,-};)=0 i=1 M i=1 i=1 E(y, -@;)(, -7)=0 i=1 Σε, i=1 n §; = a + bx, 8; = y, - §, Le prime due proprietà derivano direttamente, anzi non sono altro che le condizioni imposte dalle equazioni normali di regressione: Z(y, -a-bx, )=0 E(y, -a-bx, )x, =0 ovvero _(y,-@;)=0 M MATEMATICA Pagina 3Dimostriamo le altre due: n i=1 n Σ(17 - 32)y, = 0 i=1 i=1 n >(y ;- }; )(a+bx, )=d>(y,-y.)+b>(y ;- };)x; = 0 i=1 sono proprio le prime due proprietà = 0 _(y, -¿; )(î, - 7)= 0 i=1 i=1 i=1
Scomposizione della Devianza e Varianza
Scomposizione della Devianza (e della Varianza) di Y La devianza della variabile Y può essere scomposta in due componenti: (y, - 7)2 =>(y, - ý, )2 + >(}, - 7)2 n i=1 i=1 n i=1 n Dimostrazione: n n + i=1 i=1 i=1 = Σαι - 902 + ΣΤΙ - Γ)2 +2 Σ(17 -30)69, - 7) i=1 i=1 + N i=1 i=1 i=1 = 0 per la quarta proprietà dei residui di regressione devianza residua + devianza spiegata dal modello Lo stesso vale ovviamente anche per la varianza, basta dividere tutto per n, quindi possiamo scrivere anche la scomposizione della varianza totale di y: 0, = 'modello + O residua In virtù di questa scomposizione, si può costruire un indice standardizzato (compreso tra 0 e 1) per valutare la bontà del modello di regressione MATEMATICA Pagina 4 n n
Coefficiente di Determinazione R2
Il Coefficiente di Determinazione R2 Per valutare la bontà del modello si introduce il coefficiente di determinazione R2 rapporto tra la devianza del modello e la devianza totale della y: R2- model - E(î, - 7)2 Z(y, - 7)2 Rª misura la frazione di varianza (o di devianza) della Y spiegata dal modello R2 si può scrivere anche come: R2 = 02 modello 2 y 0 0,-resid residua 2 y ¥1- O N residua 2 y Assume valori compresi tra 0 e 1: vale 1 quando il modello spiega completamente la varianza della y: i residui sono tutti nulli, cioè i punti sono perfettamente allineati vale O quando la varianza descritta dal modello è nulla: questo accade quando la retta di regressione risulta parallela all'asse X, cioè y, = = >(, -7)2=0 · Osserviamo che per calcolare Rª è necessario calcolare tutti gli y(i) stimati per ogni x(i) osservato, e tutti gli scarti tra i valori stimati e M(y) R2- module = ΣΑΜ, - Γ)2 2 residua 2 y =1- N 6 Oppure, con la seconda formulazione, dobbiamo calcolare tutti gli scarti tra gli y stimati e quelli osservati (cioè i residui) · Possiamo però sviluppare Rª anche in un altro modo: R2_020 2 modello N V(0) V(a+bx) V(y) II 12 V(x) V(y) 2 0% - o, 2 = 0 0 N N xy = p2 6 6 6 . Il coefficiente di determinazione Ra (solo per il modello lineare di primo grado cioè per la retta di regressione) è uguale al quadrato del coefficiente di correlazione p2 · Quindi il quadrato del coefficiente di correlazione ci fornisce la frazione di varianza spiegata dal modello, senza calcolare i residui e nemmeno gli y stimati IL COEFFICIENTE DI DETERMINAZIONE R2 R2 = rapporto tra lo scostamento dei dati stimati e quello dei dati osservati, dalla media dei valori osservati (adattamento del modello ai dati). ytimedia dei valori yi; R = E(Vi-V)2 Σ(i-y)2 MATEMATICA Pagina 5 =1 0 0 V(y)R2 varia fra 0 e 1 y y y i X X X R2~ 0.3 STIMA DEGLI ERRORI Intervallo di confidenza (C.I.) -- > Confidence Interval 100 90 80 y 70 . lower 60 upper 50 40 0 5 10 15 20 25 30 35 40 45 50 - Residui -- > Weight / Standardized residuals 4 3 : Standardized residuals 2 1 0 130 150 170 -1 -2 -3 Weight
Verifica d'Ipotesi dei Parametri
VERIFICA D'IPOTESI DEI PARAMETRI -- > Sotto l'ipotesi nulla la statistica test è: t = ! B1 -b1 ~ tn- 2 S(B1) In corrispondenza del sistema d'ipotesi: Ho : B= b1 contro H1 : Bb A un livello di significatività @ la regione di rifiuto è data dai valori della statistica test superiori in valore assoluto a ta/2 . La verifica d'ipotesi più frequente è: Ho : B= 0 contro H1 : B#0 con t = 5 (B ) BI ~tn-2 ossia che la Y sia indipendente in media dalla X. MATEMATICA Pagina 6 - R2~ 1 R2~ 0.6 ·
Verifica d'Ipotesi del Modello
VERIFICA D'IPOTESI DEL MODELLO -- > Per valutare la significatività del modello si ricorre al test F: tramite la ANOVA per un modello di regressione lineare multipla, consiste in un test globale su tutti i parametri del modello (eccetto Bo) e in particolare nel confronto tra la devianza del modello saturo (o non vincolato) Y = Xß+& e quella del modello vincolato (o ridotto) Y = p.12 +8 . Le ipotesi saranno n= righe k= colonne indipendenti (regressori) H. : B=B2 = ... = Bx=0 H1 : almeno uno dei ß; ¢0 Si costruisce la statistica test F SQR/(k) F = SQE|(n-k-1) Che sotto l'ipotesi nulla ha distribuzione F (k,n-k-1) Fissato il livello di significatività a si individua il valore critico della distribuzione · Se F>F(c.k.n-k-1) si rifiuta Ho ovvero si accetta la significatività congiunta di tutte le variabili esplicative.
Stima Puntuale
STIMA PUNTUALE PARAMETRO (O): valore ignoto della popolazione (ad esempio la media u dell'universo) STIMATORE (T): variabile di cui ci serviamo per risalire (stimare) il valore ignoto O (ad esempio la media campionaria X) STIMA (t): valore dello stimatore osservato nel campione considerato Errore di campionamento: O-t
Correttezza e Distorsione
CORRETTEZZA: Uno stimatore T è CORRETTO se la media di tutte le stime t su tutti i campioni dello spazio campionario (l'insieme di tutti i campioni estraibili dall'intero universo) coincidono con ℮ DISTORSIONE: E(T)=0 In caso contrario lo stimatore T si dirà DISTORTO: E(T) - 0 # 0 Media campionaria stimatore corretto di u E(X)=p MATEMATICA Pagina 7U={1,2,3} μ=2 Spazio campionario bernoulliano, n=2 (1,1),x=1 (1,2),x=1.5 (1,3),x=2 (2,1), x=1.5 (2,2),x=2 (2,3), x=2.5 (3,1), x=2 (3,2), x=2.5 (3,3),x=3 Media campionaria ni pi 1 1 1/9=0.11 1.5 2 2/9=0.22 2 3 3/9=0.33 2.5 2 2/9=0.22 3 1 1/9=0.11 Totale 9 1 Ε(Χ)=ΣxΡ. Ε(Χ)=1·0. ΙΙ +1.5-0.22+2-0.33 +2.5-0.22+3-0. Π =2=μ
Varianza della Media Campionaria
Varianza della media campionaria Campionamento bernoulliano VAR(X)=02 Media campionaria pi 1 0.11 1.5 0.22 2 0.33 2.5 0.22 3 0.11 Totale 1 U={1,2,3} o2=0.67 VAR (X)=Σ(x]· p.)-E(X)} 1- VAR(X)=[12-0.11+1.52-0.22+ 23-0.33+2.52.0.22+32.0.11]-2}=0.33 VAR(X) == 0.67-0.33
Stima della Media
STIMA DELLA MEDIA -- > Sia X una variabile casuale (v.c.) che interpreta un certo fenomeno oggetto di studio (per esempio il reddito, l'età, il peso, ... ) di media E(X) = p e varianza Var(X) = = 2 entrambe ignote poiché non si conosce l'intera popolazione. Vogliamo usare le osservazioni X1 X2 ..... X7 per ottenere informazioni su u e o Introduciamo uno STIMATORE per u: la MEDIA CAMPIONARIA X = i=1 n Media della media campionaria: E[X] = u Infatti: n E Exi n i=1 n 1 n =1 ΣΕ[x;] === μ => STIMATORE NON DISTORTO MATEMATICA Pagina 8
Can’t find what you’re looking for?
Explore more topics in the Algor library or create your own materials with AI.
