Bioinformatica: analisi delle varianti genetiche e strumenti di predizione
Slide di Università su Bioinformatica - Lezione 4. La Pdf esplora l'analisi delle varianti genetiche in bioinformatica, con focus su filtering, annotazione e strumenti come Polyphen2, SIFT e CADD, utile per gli studenti di Informatica.
Mostra di più10 pagine

Visualizza gratis il Pdf completo
Registrati per accedere all’intero documento e trasformarlo con l’AI.
Anteprima
Bioinformatica: Lezione 4 (20 marzo 2024)
Continuazione lezione 3
Filtering delle varianti genetiche
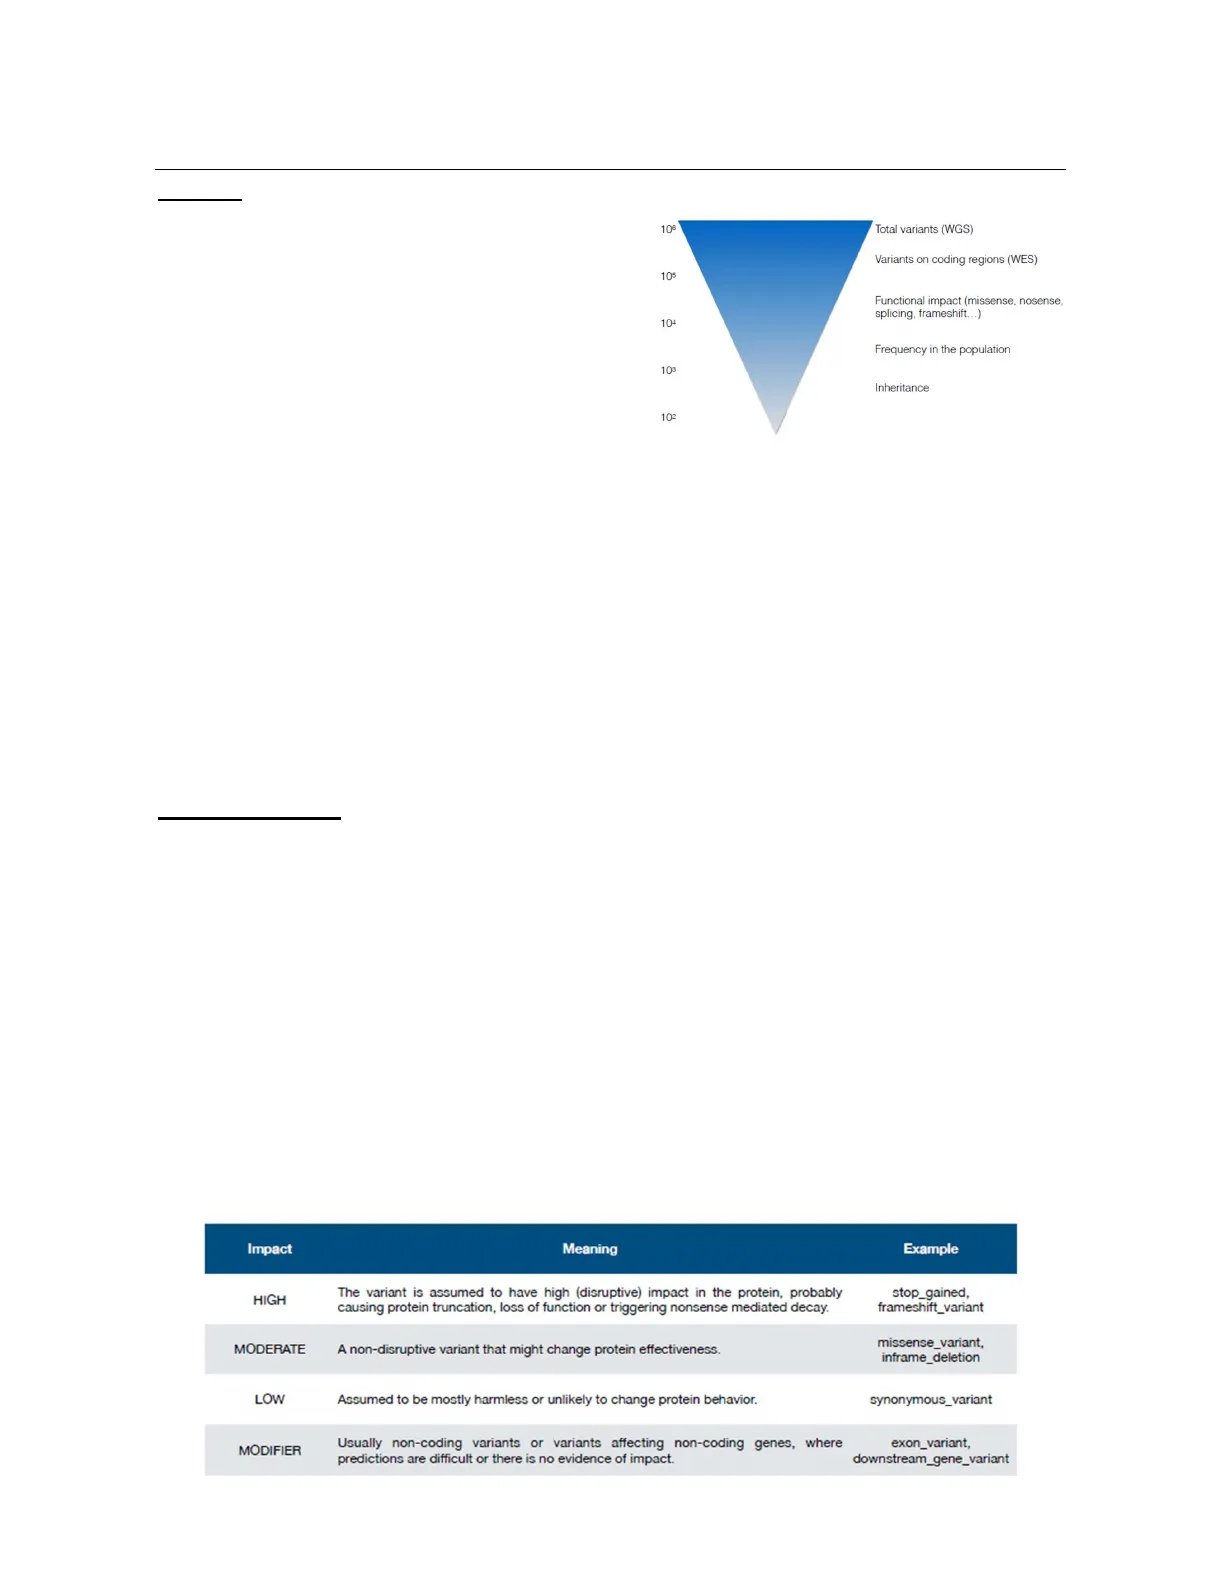
Nell'immagine sono rappresentati esempi di ordini di
10
Total variants (WGS)
grandezza che ci si può aspettare quando si fa una
Variants on coding regions (WES)
chiamata di varianti da un singolo individuo. Partendo
105
dalle varianti totali che sono sull'ordine del milione si
Functional impact (missense, nosense,
104
splicing, frameshift ... )
scende applicando filtri in base all'impatto in termini
funzionali per arrivare a identificare varianti che possono
Frequency in the population
essere interessanti. Si possono fare nell'ipotesi che si
103
Inheritance
stiano cercando varianti legate per esempio a una malattia
mendeliana e quindi che abbiano una bassa frequenza
102
nella popolazione partendo dal presupposto che varianti frequenti non hanno nessun impatto sul fenotipo.
Tendenzialmente la frequenza di una variante all'intero di una popolazione sequenziata è proporzionale alla
frequenza della malattia che si sta studiando, ad esempio una variante causativa di una malattia rara che
colpisce una persona ogni 100'000 individui non ci si può aspettare che sia frequente, inoltre se si ha a
disposizione la struttura di un trio (genitori e individuo) si possono applicare ulteriori filtri su come è stata
ereditata la variante, se si ha l'idea che la variante è causativa di una malattia con schema recessivo a quale
punto non si vanno a cercare varianti in eterozigosi ma varianti omozigotiche in entrambi i genitori. Quando
si vuole caratterizzare una variante causativa di una malattia l'idea è quella di scendere fino a un numero
trattabile anche da una persona arrivando all'ordine delle decine o al massimo centinaia. Al giorno d'oggi ci
sono una serie di cataloghi e annotazioni sull'impatto noto di molte varianti però nell'ottica di dover cercare
qualcosa mai descritto prima a un certo punto bisogna studiare il potenziale impatto della variante
identificata e dev'essere un numero trattabile da un singolo o comunque da un piccolo gruppo di modo da
poter cercare letteratura o fare test.
Variant annotation
Una volta sequenziato e ottenuta una lista di varianti la prima cosa che si fa è andare a vedere se sono state
già descritte da altri studi, esiste un database che si chiama dbSNP dove sono registrate le varianti venute
fuori nel corso degli anni, in questi database ci sono informazioni sulle frequenze nella popolazione globale o
se sono note associazioni con malattie etc ... L'altra cosa che si fa è cercare di predire o di annotare le
variabili in termini dell'effetto della proteina generata: si possono definire diversi livelli di impatto, alto,
moderato, basso e modifier (inutile) a seconda del tipo di variante trovato.
Se si trova una variante che inserita in frame nella sequenza del gene tradotta in proteina tronca la proteina
oppure cambia il frame di lettura della proteina questa ha un impatto alto, la proteina che si genera non è più
quella di prima. Ci sono poi varianti che possono cambiare un solo codone come delezione o l'inserzione di
un codone, la proteina avrà solo un amminoacido in più o in meno ma rimarrà la stessa, questo è considerato
un impatto moderato. Ci sono poi le varianti sinonime che sono varianti che per via del codice genetico
degenerato non hanno impatto sulla traduzione. Tutto il resto sono varianti su regioni non codificanti come le
regioni introniche che vengono definite modifiers perché non si può predirre l'impatto sulla proteina ma è
anche difficile definirne l'impatto a livello globale.
Livelli di impatto delle varianti
| Impact | Meaning | Example |
|---|---|---|
| HIGH | The variant is assumed to have high (disruptive) impact in the protein, probably causing protein truncation, loss of function or triggering nonsense mediated decay. | stop_gained, frameshift_variant |
| MODERATE | A non-disruptive variant that might change protein effectiveness. | missense_variant, inframe_deletion |
| LOW | Assumed to be mostly harmless or unlikely to change protein behavior. | synonymous_variant |
| MODIFIER | Usually non-coding variants or variants affecting non-coding genes, where predictions are difficult or there is no evidence of impact. | exon_variant, downstream_gene_variant |
Bioinformatica
Lezione 4
20 marzo 2024
Predire l'impatto di una mutazione-variante non significa che poi l'effetto sia reale, i geni sono
intrinsecamente polimorfici, per esempio gli olfattori receptors sono geni le cui proteine possono sopportare
un'estrema variazione della sequenza anche perché sono evoluti per essere tali. Ci sono degli studi che
dimostrano che qualunque individuo sano porta sempre circa un centinaio di loss of function, si stima che
almeno una ventina siano in omozigosi e quindi non siano proprio funzionali, eppure possono non avere un
effetto evidente sull'individuo. Sono anche noti dei casi in cui varianti sinonime hanno un impatto sulla
proteina, per esempio cambiano la stabilità dell'mRNA prima dello spliicng e quindi ci può essere splicing
alterantivo e quindi proteine che sulla carta dovrebbero essere uguali poi non lo sono.
Tutte queste predizioni sono fatte con algoritmi che possono essere sbagliati. Ci sono una serie di casi in cui
combinazioni di eventi nella coding sequence vengono predetti in una maniera e nella realtà sono poi
diverse. Si immagini un caso in cui si ha una piccola delezione e più a valle un'inserzione, questi due eventi
distanti vengono considerati separatamente quando invece nella realtà la somma di queste due non fa nulla
alla proteina. Un esempio è una variante che impatta sullo splice e poi una variante sull'esone successivo che
è saltato, l'ordine con cui si predice questa cosa da un'informazione diversa perché se si assume che lo splice
site mutato fa saltare l'esone, la variante di quell'esone anche se fosse uno stop codon non avrebbe nessun
impatto quando invece se predette separatamente la variante dello stop codon dà un impatto molto più
elevato, computizionalmente quella è la variante disurptive per il gene ma nella realtà non è così.
Inoltre, la cosa più importante è che gli esseri viventi sono complicati, spesso anche se una proteina non
funziona esistono una serie di meccanismi che impediscono che una cellula muoia o smetta di funzionare per
una singola mutazione oltre ai meccanismi di riparo del DNA. La probabilità di inserire una mutazione
durante la duplicazione del DNA non è un evento così raro, i sistemi cellulari sono molto robusti rispetto al
cambiamento altrimenti l'uomo si sarebbe estinto molti anni fa, l'altra cosa è che l'espressione di un gene e il
suo prodotto è tessuto specifica e può cambiare nel corso della vita quindi se si ha una mutazione e una
variante di un gene che verrà espresso solo in vita adulta non si avrà una malattia che impatta sullo sviluppo
dell'individuo.
Una cosa è predire l'effetto su una proteina un altro è predire l'impatto fenotipico e per fare questo ci sono
una serie di strumenti, algoritmi con logiche diverse che possono predire il reale impatto funzionale
sull'individuo e sul fenotipo, molti studiano mutazioni di siti conservati e ci si aspetta che possano avere un
impatto maggiore.
Polyphen2: classificazione dell'impatto delle varianti
Questo algoritmo tenta di classificare l'impatto della variante in benign, possible damaging o damaging ed è
basato sullo studio di alcune varianti sui cambianti strutturali indotti sulle proteine, andando a studiare come
la variante modifica l'accesso a un sito catalitico o il folding della proteina stessa. Tutti i dati sono
collezionati in una serie di molti esperimenti da cui l'algoritmo impara e sulla base di queste proprietà sa
quali cambiamenti strutturali causano e viene creato un classificatore che esprime una classificazione basata
sui tre valori citati e basta, quindi è anche facile da interpretare.
SIFT: predizione della tolleranza al cambiamento amminoacidico
SIFT è basato sull'impatto che si può predirre con il cambiamento di un amminoacido con un altro, si basa
sullo studio di grossi allineamenti post genes e quello che viene restituito non è una classificazione ma una
probabilità di tolleranza del cambiamento. Se questo numero è sotto lo 0.05 è considerata una variante non
tollerata perché il cambiamento amminoacidico che produce è considerato non frequente all'interno di un set
di sequenze omologhe e come con gli allineamenti, viene considerato un evento raro e quindi non tollerato.
CADD: score di patogenicità delle varianti
Questo strumento invece di inventarsi uno score nuovo prende una serie di notazioni note, mette tutto
assieme e restituisce un valore da 1 a 99 dove 1 è damaging e 99 è tollerato. Questo è l'approccio più
"naturale". Questi valori sono già stati calcolati una volta e rilasciati come tali, quindi i valori di CADD sono
disponibili per tutte le possibili sostituzioni che ci possono essere o per la maggior parte di esse.
Variazione genetica e fenotipo
Bioinformatica
Lezione 4
20 marzo 2024
L'impatto che possono avere le varianti sul fenotipo
Genome variation
Effect
dell'individuo è variabile e in uno spettro e la deviazione di
size
Personal genome
(exome and whole
genome resequencing)
un fenotipo da sano a qualcos'altro è l'effetto della variante
· Mendelian diseases
· Family-based approach
che viene definito effect size, che ha a che fare con la
Genome-wide
· Common diseases
· Rare variants
association
studies (GWAS)
statistica e si riferisce alla quantifica dell'impatto che una
variante può avere su qualcosa. Questo è strettamente relato
· Substantial effect size
alla penetranza di una mutazione che permette di classificare
· Common diseases
. Common variants
· Small effect size
la relazione che c'è tra le varianti e il tipo di malattia che
queste possono causare. Varianti molto rare proprio perché
sono rare nel corso dell'evoluzione vengono continuamente
Variant
Very rare
Common
frequency
selezionate e vengono associate a malattie genetiche anche gravi con fenotipi evidenti e quindi con un largo
effect size. Dall'altra parte dello spettro ci sono varianti comuni che hanno un effect size molto lieve non
clinico che non sono legate per forza a patolgoie (colore degli occhi, altezza ... ); siccome l'effect size è
piccolo per avere il potere statistico per studiarle servono delle coorti molto grandi, perché altrimenti non si
ha una buona stima della varianza, non si effettua il sequenziamento perché costerebbe troppo ma si usano
tecnologie come DNA microarray o SNP array. In mezzo c'è tutta una serie di varianti tendenzialmente rare
ma che non hanno effetto così disruptive che possono essere studiate in coorti non gigantesche con studi di
genomi personali, quindi sequenziamento di singoli individui, e sono rappresentate da un build-up di tutto
quello che è la struttura genetica di tante varianti in tanti geni che contribuiscono al fenotipo.
GWAS: studi di associazione genome-wide
Questo tipo di architetture vengono studiate con i GWAS che proprio perché studiano varianti che hanno
effect size piccoli, il cui effetto sul fenotipo è dovuto alla variazione dell'effetto di tante varianti necessitano
di grandi coorti e soprattutto anche di adeguati controlli in termini di dimensioni e di proprietà della coorte.
Fare un GWAS dal punto di vista procedurale è molto semplice perché quello che si fa è per ogni variante si
va a registrare il genotipo di ogni individuo della coorte che può essere omozigote o eterozigote sia nel set
dei casi che dei controlli e la statistica che si fa è semplice e restituisce è il confronto tra attesi (controllo) e
osservati (casi) e il p-value restituito dice se la variante osservata è associata, quindi se un certo genotipo è
più arricchito nei casi rispetto che nei controlli. Con gli SNP array si parla di milioni di SNP e quindi miliardi
di p-value e quindi il problema è che ogni singolo test ha il rischio di dare un risultato falso positivo e quindi
quello che si fa è la correzione del p-value per minimizzare il rate dei falsi positivi e per esempio un metodo
di correzione è la correzione di Bonferroni per avere solo l'1% di cascare in falsi positivi. Se l'ordine di
grandezza è di 10^6 p-values il primo p-value significativo dovrebbe essere inferiore a 10^-8, un effetto
dev'essere o molto grande o estremamente poco variabile per poter avere dei p-value di quell'orine di
grandezza, se si considera che negli SNP array l'ordine di grandezza viene moltiplicato per mille dove
potenzialmente si hanno i valori di genotipi per tre miliardi di basi, il p-value che si dovrebbe avere con la
correzione di Bonferroni dovrebbe essere intorno a 10^-11 che vuol dire che la coorte inizia a diventare
veramente grande.
Testing variants: modelli di associazione genotipo-fenotipo
Partendo dal dato di partenza, per ogni tipo di genotipo e per ogni variante si ha un numero nei casi e nei
controlli. Le varianti in eterozigosi vanno considerate come variante positiva o negativa in base al modello
applicato. In caso si consideri che avere la variante anche in eterozigosi sia sufficiente per avere un fenotipo,
si ha il modello dominante e la matrice diventa una tabella 2x2 dove le conte dei genotipi eterozigoti si
sommano agli omozigoti varianti. Viceversa, nel modello recessivo avere la variante in eterozigosi non è
sufficiente per associarla al fenotipo e quindi nella tabella 2x2 la conta degli eterozigoti si somma a quella
dell'assenza della variante. C'è anche la possibilità del modello moltiplicativo dove non si fa un discorso di
genotipi ma si contano i reali alleli e si contano quanti alleli di tipo A o B ci sono (varianti 0 o 1) e ogni
omozigote conta due volte per l'allele a cui viene sommato quante volte c'è l'eterozigote sia per A che per B.
Non hai trovato quello che cercavi?
Esplora altri argomenti nella Algor library o crea direttamente i tuoi materiali con l’AI.
